9.3 회귀·모형적합
9.3 회귀·모형적합
두 변수 사이에 관계가 있어 보일 때, "이 변수가 1만큼 커지면 저 변수는 얼마나 변하는가?", "이 조건에서는 값이 얼마로 예측되는가?"처럼 정량적인 질문에 답하고 싶은 경우가 많습니다. 그런데 상관계수(cor())는 관계의 강도와 방향만 알려줄 뿐, 정작 예측에 쓸 수 있는 식은 주지 않습니다.
아래 코드를 실행하면 자동차 무게(wt)가 클수록 연비(mpg)가 낮아지는 뚜렷한 경향을 산점도로 확인할 수 있습니다.
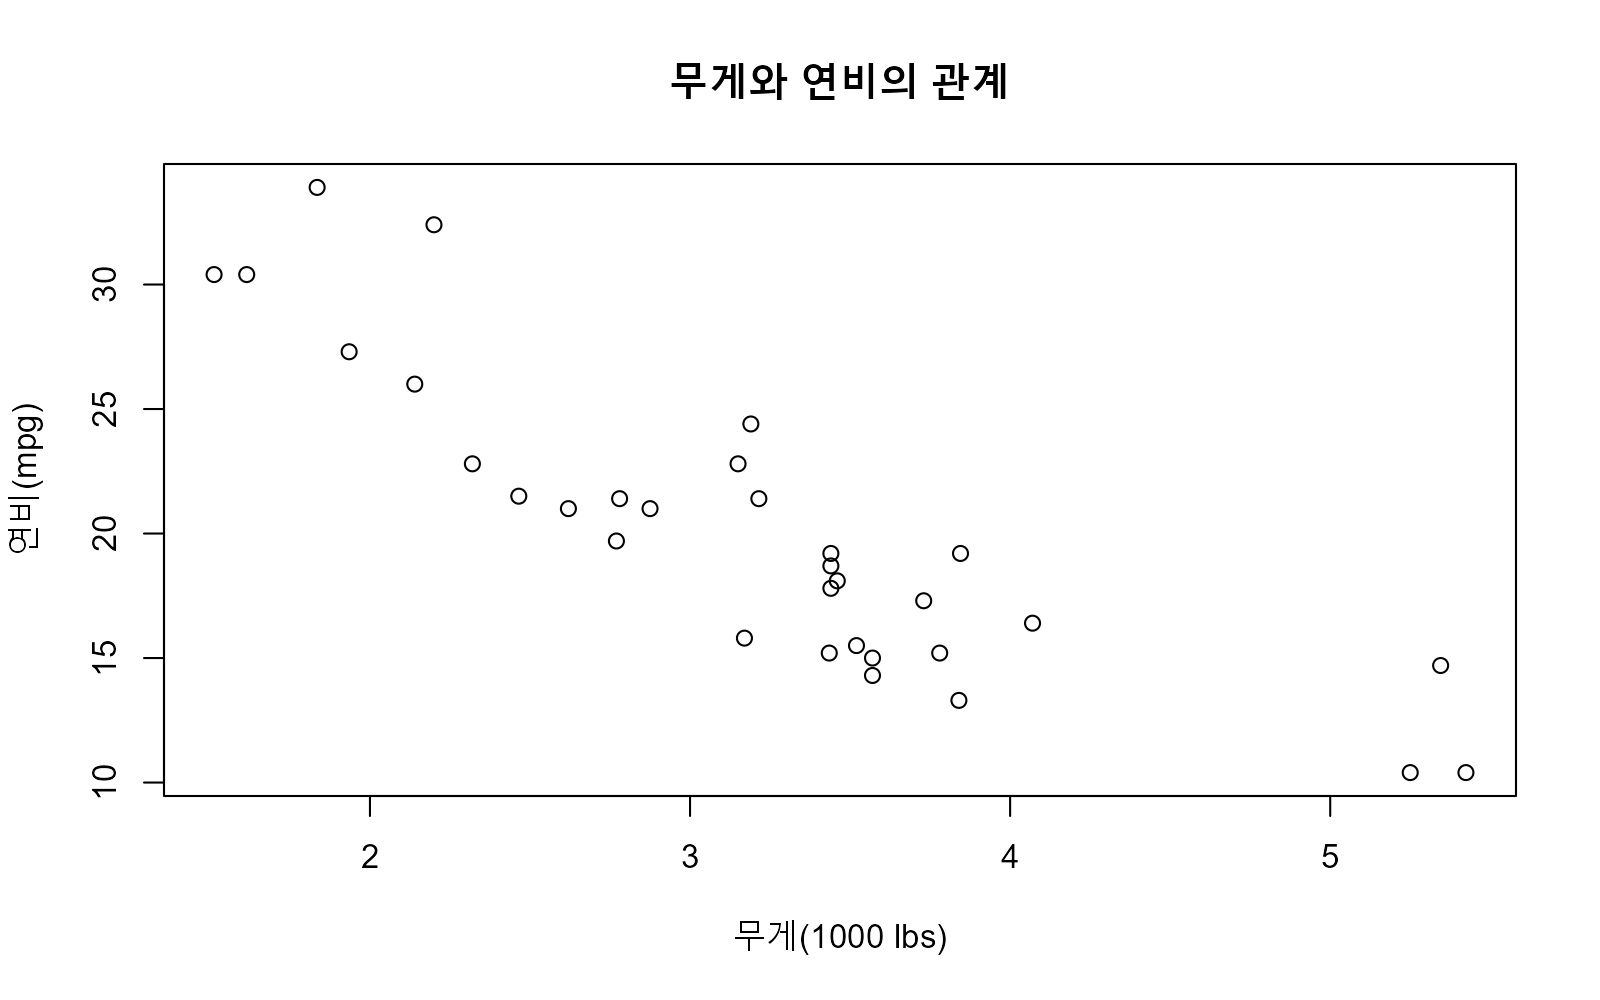
이 산점도만으로는 "무게가 1000lbs 늘어나면 연비가 정확히 얼마나 줄어드는가?"라는 질문에 답할 수 없습니다. 점들을 관통하는 직선(또는 곡선)의 식이 있어야만 이 질문에 숫자로 답하고, 아직 관측하지 않은 무게 값에 대해서도 연비를 예측할 수 있습니다.
R은 "관계를 수식화한다"는 이 문제를 상황별로 나누어 다음과 같은 함수들로 제공합니다.
| 상황 | 사용하는 함수 |
|---|---|
| 반응변수가 연속형이고, 관계가 직선(또는 직선으로 변환 가능)일 때 | lm() |
| 반응변수가 이항형·개수형 등이라 정규분포를 가정할 수 없을 때 | glm() |
| 관계가 곡선형이지만 다항식으로 근사할 수 있을 때 | poly() + lm() |
| 관계식 자체가 비선형 함수(예: 포화곡선, 성장곡선)로 명시적으로 주어질 때 | nls() |
| 설명변수 후보가 많아 어떤 조합이 적절한지 탐색하고 싶을 때 | step() |
| 적합된 모형으로 새로운 값을 예측하고 싶을 때 | predict() |
| 여러 변수(차원)를 소수의 요약 축으로 줄이고 싶을 때 | princomp() (prcomp()) |
lm()·glm()·nls()처럼 데이터에 모형을 적합시키는 함수는 모두 formula라는 동일한 문법 체계(~, +, ., -, :, *, I())를 공유하므로, lm()에서 이 문법을 자세히 배워두면 나머지 함수에서는 반복 설명 없이 바로 응용할 수 있습니다.
lm()
lm(formula, data, subset, weights, na.action, method = "qr", model = TRUE, x = FALSE, y = FALSE, qr = TRUE, singular.ok = TRUE, contrasts = NULL, offset, ...)는 선형모델(linear model), 즉 (다중) 회귀분석을 적합시키는 함수입니다. R의 회귀분석·분산분석 관련 함수들의 기초가 되는 함수로, 이후 배울 glm(), step(), predict()도 모두 lm()이 반환하는 객체 구조와 formula 문법을 그대로 물려받습니다.
주요 인자
formula: 적합할 모델을 나타내는 식.반응변수 ~ 설명변수1 + 설명변수2 + ...형태로 씁니다. 아래에서 각 기호(~,+,.,-,:,*,I())를 하나씩 다룹니다.data: formula에 쓰인 변수들이 들어있는 데이터프레임. 생략하면 현재 환경(전역 환경)에서 같은 이름의 변수를 찾는데, 변수의 출처가 모호해지고 재현성이 떨어지므로 특별한 이유가 없다면 항상 지정하는 것이 좋습니다.subset: 데이터 중 일부 행만 적합에 사용하고 싶을 때 지정하는 논리식 또는 인덱스. 예를 들어subset = (cyl == 6)이라고 지정하면 실린더가 6개인 자동차만 골라 적합합니다.weights: 관측치마다 서로 다른 가중치를 부여하고 싶을 때 지정합니다. 관측치별로 오차의 분산이 다른(이분산, heteroscedasticity) 상황에서, 분산이 큰(불확실성이 큰) 관측치의 영향력은 줄이고 분산이 작은(신뢰도가 높은) 관측치의 영향력은 늘리기 위한 가중최소제곱법(WLS, Weighted Least Squares)에 사용합니다. 보통 분산의 역수(1/분산)를 가중치로 씁니다.na.action: 결측치(NA) 처리 방법. 기본값은options("na.action")에 설정된 값(보통na.omit)입니다.na.omit: 설명변수나 반응변수 중 하나라도 NA인 행을 아예 제거하고 적합합니다.na.exclude:na.omit과 마찬가지로 적합에서는 제외하지만,residuals()·fitted()등 적합 후 결과에는 제외된 행의 자리에 NA를 그대로 채워 넣어 원본 데이터와 행 번호(길이)를 맞춰 줍니다. 원본 데이터와 나란히 붙여 봐야 할 때 유용합니다.na.fail: 결측치가 하나라도 있으면 조용히 넘어가지 않고 에러를 발생시킵니다. 결측치가 없어야 함을 사전에 보장하고 싶을 때 사용합니다.method: 적합에 사용할 계산 방법. 기본값"qr"은 QR 분해를 이용하는, 수치적으로 안정된 방식입니다."model.frame"으로 지정하면 실제 적합은 하지 않고 모델 프레임(정리된 데이터)만 반환합니다.model,x,y,qr: 적합된 결과 객체에 각각 모델 프레임, 모델(설계) 행렬, 반응변수 벡터, QR 분해 결과를 포함시켜 반환할지 여부를 나타내는 논리값입니다. 기본은model = TRUE만 켜져 있습니다. 켜두면predict()나update()등을 다시 계산할 때 편리하지만, 데이터가 매우 크면 메모리를 많이 차지하므로 굳이 필요 없다면 꺼도 됩니다.singular.ok: 설계행렬이 완전한 열계수(full column rank)를 갖지 못하는 특이(singular) 상황(예: 완전히 중복되는 설명변수가 있는 경우)에서도 적합을 허용할지 여부입니다. 기본값TRUE에서는 이런 경우 일부 계수가NA로 표시되는 방식으로 처리되고,FALSE로 지정하면 에러가 납니다.contrasts: 팩터(범주형) 설명변수를 수치형 더미변수로 바꾸는 대비(contrast) 방식을 지정합니다. 생략하면options("contrasts")의 기본값(보통 처리대비contr.treatment)이 쓰입니다.offset: 계수를 정확히 1로 고정한 채 선형예측식에 그대로 더해 넣는 항입니다. 이미 알고 있는 효과를 모형에 반영하고 싶을 때 사용하며, 뒤에서 다룰glm()의 포아송 회귀에서 노출량(exposure)을 보정하는 용도로 더 자주 쓰입니다.
formula에 쓰이는 기호: ~, +, ., -, :, *, I()
formula 인자는 ~, +, ., -, :, * 같은 기호로 모델의 구조를 표현합니다. 이 기호들은 산술 연산자와 모양은 같지만 formula 안에서는 모델 구조를 지정하는 전혀 다른 의미로 쓰인다는 점에 유의해야 합니다.
~ 기호는 반응변수(종속변수)와 설명변수(독립변수)를 구분 짓는 기호로, 반응변수 ~ 설명변수 형태로 사용합니다. 아래 예제의 mpg ~ wt는 반응변수 mpg와 설명변수 wt로 이루어진 단순선형회귀 모델을 의미합니다. 적합 결과는 summary()로 자세히 살펴보는 것이 좋습니다.
fit <- lm(mpg ~ wt, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ wt, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -4.5432 -2.3647 -0.1252  1.4096  6.8727
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept)  37.2851     1.8776  19.858  < 2e-16 ***
#> wt           -5.3445     0.5591  -9.559 1.29e-10 ***
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 3.046 on 30 degrees of freedom
#> Multiple R-squared:  0.7528, Adjusted R-squared:  0.7446
#> F-statistic: 91.38 on 1 and 30 DF,  p-value: 1.294e-10
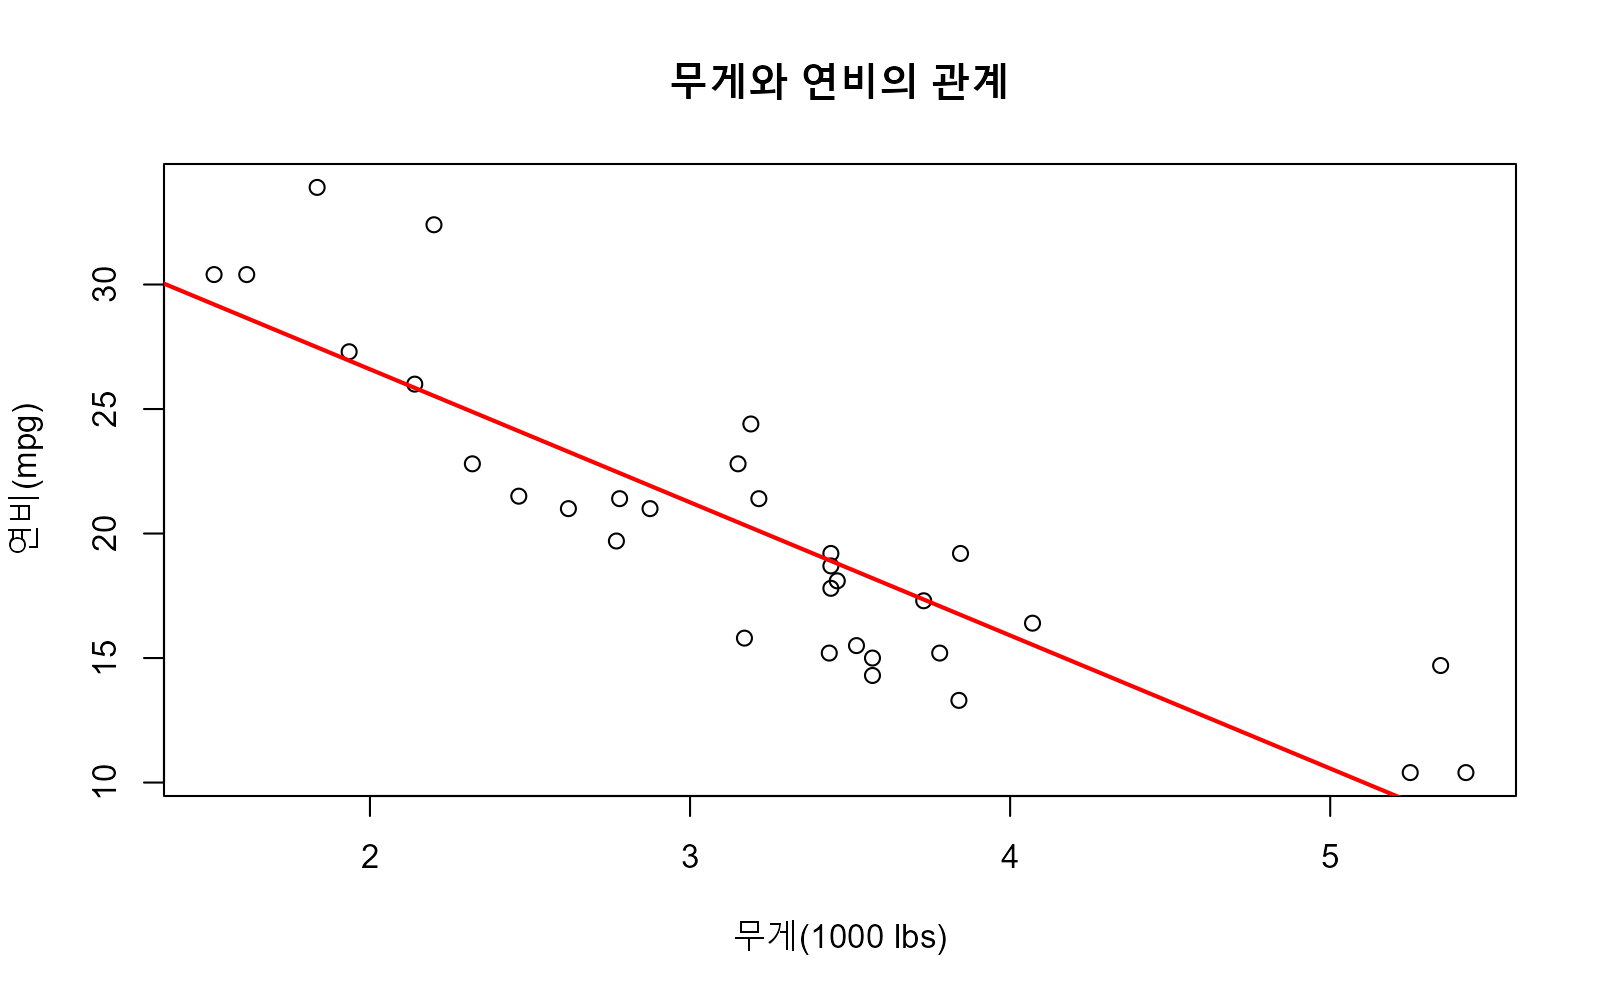
계수(Coefficients) 표의 (Intercept)는 절편, wt는 기울기입니다. 즉 mpg ≈ 37.29 - 5.34 × wt로 해석하며, "무게가 1(=1000lbs) 늘어날 때마다 연비는 평균적으로 5.34만큼 줄어든다"는 뜻입니다. 산점도 위에 이 회귀직선을 그려서 눈으로 확인하려면 다음 코드를 실행합니다.
plot(mtcars$wt, mtcars$mpg, xlab = "무게(1000 lbs)", ylab = "연비(mpg)")
abline(fit, col = "red", lwd = 2)
참고: R 4.1+ 네이티브 파이프와 함께 쓰기
2.8절에서 다룬 네이티브 파이프(
결과는 위|>)와 R 4.2+의 언더바 플레이스홀더(_)를 이용하면 데이터프레임을 파이프로 넘기면서 바로lm()을 호출할 수도 있습니다.data인자처럼 이름이 있는 인자에만_를 쓸 수 있다는 점에 유의합니다.fit과 완전히 동일합니다.
+ — 여러 설명변수 더하기(다중회귀)
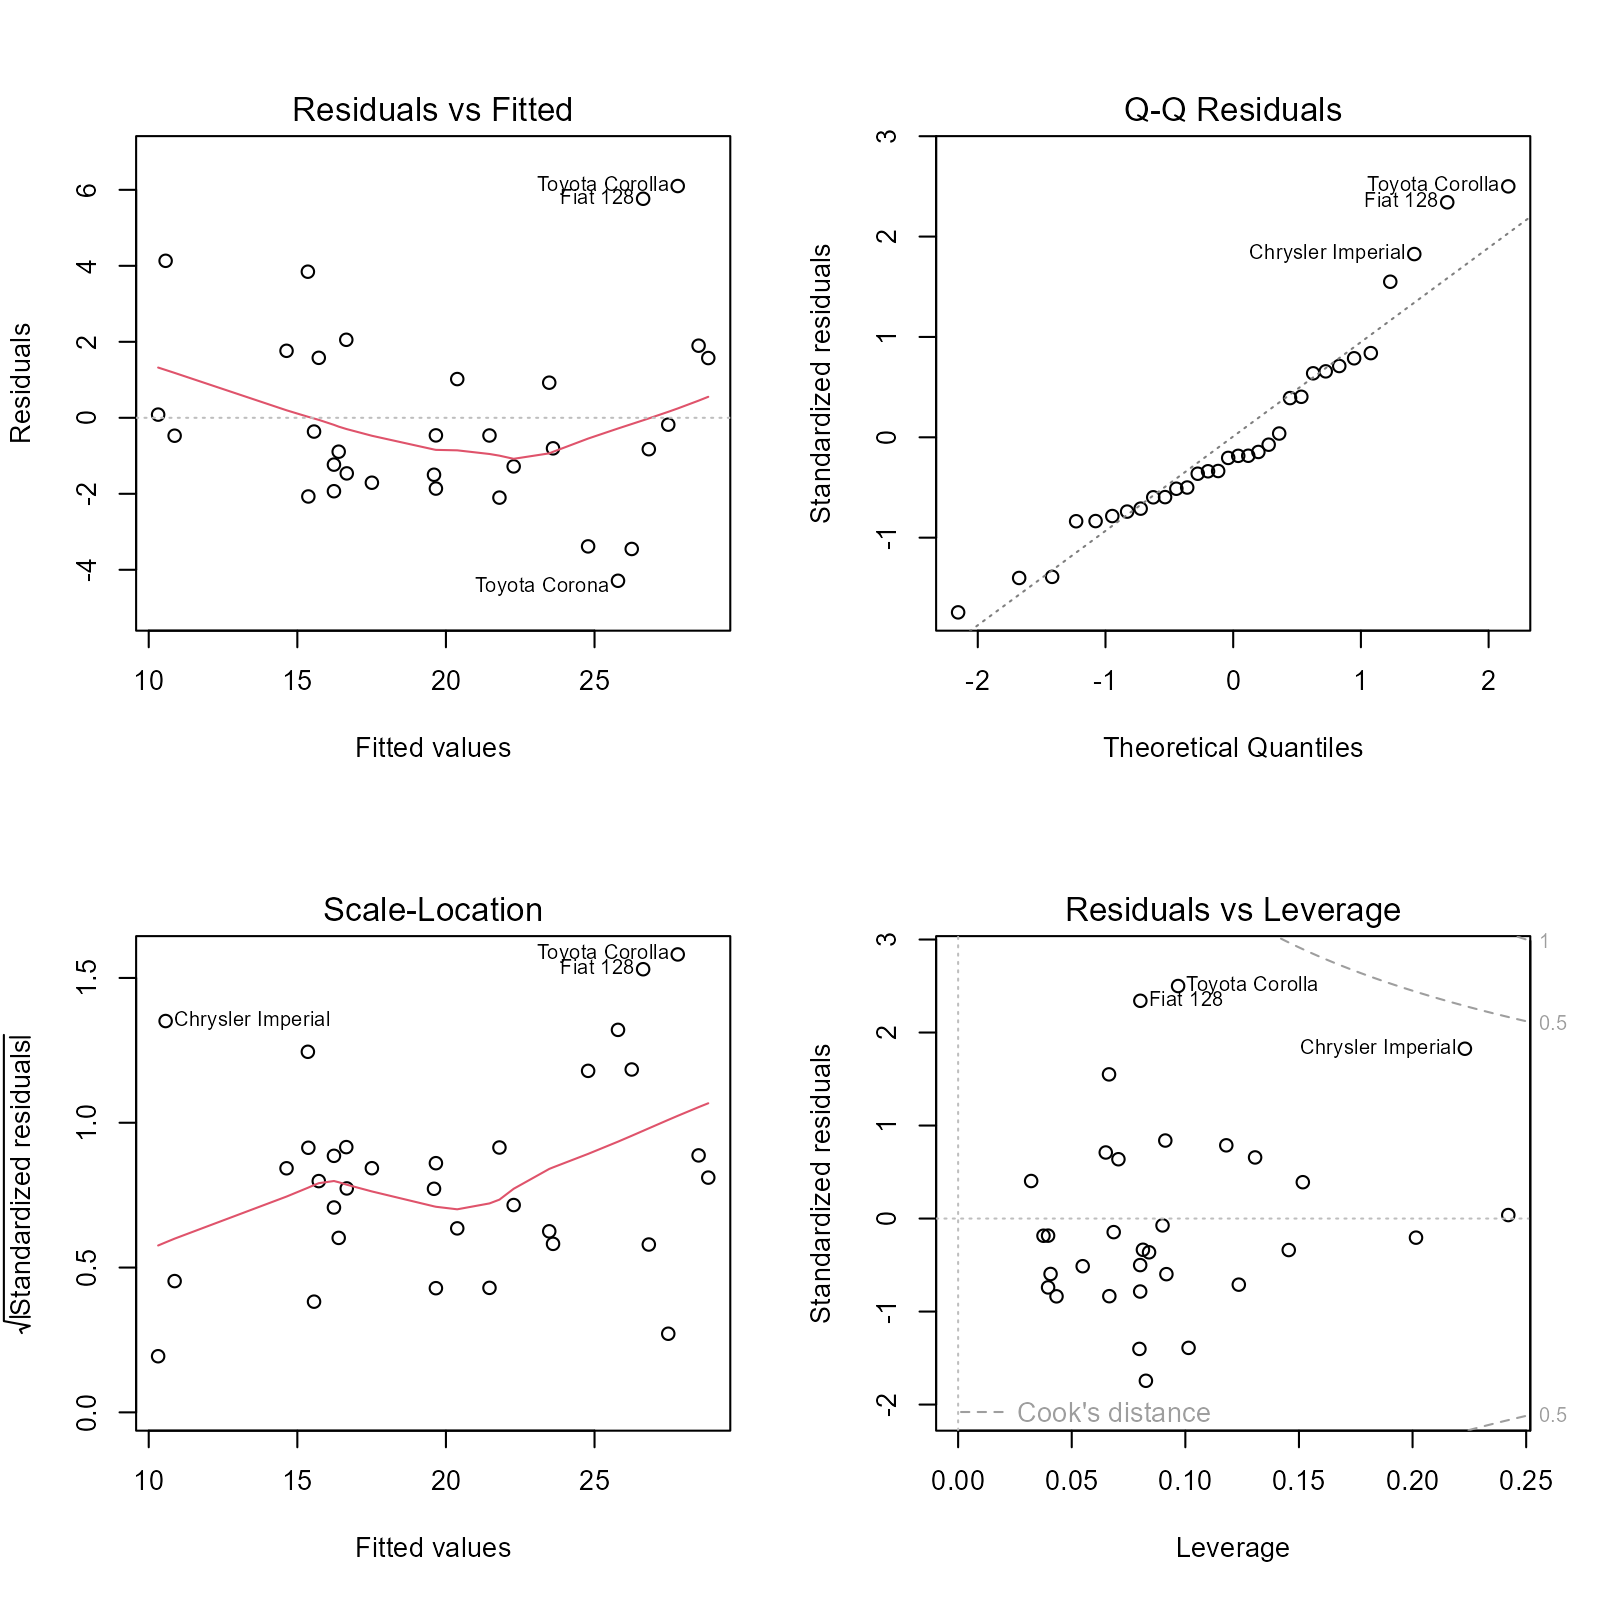
+ 기호는 설명변수를 여러 개 나열해 다중회귀분석을 수행할 때 사용합니다. plot(fit)은 적합된 회귀모형을 진단하기 위한 4가지 그래프(잔차 대 적합값, Q-Q plot, 표준화잔차, 지레값-잔차)를 그려 주며, 선형성·정규성·등분산성 가정과 이상치를 점검하는 데 쓰입니다. 진단 그래프의 해석은 9.6절(모형 진단)에서 더 자세히 다룹니다.
fit <- lm(mpg ~ wt + cyl, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ wt + cyl, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -4.2893 -1.5512 -0.4684  1.5743  6.1004
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept)  39.6863     1.7150  23.141  < 2e-16 ***
#> wt           -3.1910     0.7569  -4.216 0.000222 ***
#> cyl          -1.5078     0.4147  -3.636 0.001064 **
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 2.568 on 29 degrees of freedom
#> Multiple R-squared:  0.8302, Adjusted R-squared:  0.8185
#> F-statistic: 70.91 on 2 and 29 DF,  p-value: 6.809e-12
. — 나머지 변수 전부
. 기호는 "데이터프레임에 있는 나머지 변수 전부"를 뜻합니다. 반응변수를 제외한 모든 열을 설명변수로 쓰고 싶을 때 반응변수 ~ . 형태로 모델을 만듭니다. 변수가 많을 때 일일이 나열하지 않아도 되어 편리하지만, 정말 필요한 변수인지 따져보지 않고 습관적으로 쓰면 불필요한 변수까지 모두 투입되어 해석이 어려워질 수 있으므로 주의가 필요합니다.
fit <- lm(mpg ~ ., data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ ., data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -3.4506 -1.6044 -0.1196  1.2193  4.6271
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept) 12.30337   18.71788   0.657   0.5181
#> cyl         -0.11144    1.04502  -0.107   0.9161
#> disp         0.01334    0.01786   0.747   0.4635
#> hp          -0.02148    0.02177  -0.987   0.3350
#> drat         0.78711    1.63537   0.481   0.6353
#> wt          -3.71530    1.89441  -1.961   0.0633 .
#> qsec         0.82104    0.73084   1.123   0.2739
#> vs           0.31776    2.10451   0.151   0.8814
#> am           2.52023    2.05665   1.225   0.2340
#> gear         0.65541    1.49326   0.439   0.6652
#> carb        -0.19942    0.82875  -0.241   0.8122
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 2.65 on 21 degrees of freedom
#> Multiple R-squared:  0.869,  Adjusted R-squared:  0.8066
#> F-statistic: 13.93 on 10 and 21 DF,  p-value: 3.793e-07
설명변수 10개를 모두 넣었더니 오히려 개별 변수의 유의확률(Pr(>|t|))은 대부분 크게 나옵니다. 이는 설명변수들끼리 서로 겹치는 정보를 담고 있어(다중공선성) 각 변수의 순수한 기여도를 구분하기 어려워졌기 때문입니다. 적절한 변수 조합을 탐색하는 방법은 바로 다음에 배울 step()에서 다룹니다.
- — 일부 변수 제외
- 기호는 +의 반대로, 특정 설명변수를 모델에서 제외할 때 사용합니다. .으로 모든 변수를 넣은 뒤 일부만 골라 빼는 방식으로 자주 함께 쓰입니다.
fit <- lm(mpg ~ . - cyl - disp - hp - drat - qsec - vs - carb, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ . - cyl - disp - hp - drat - qsec - vs -
#>     carb, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -4.1663 -2.4342 -0.2539  1.5132  6.6583
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept)  39.2114     5.2849   7.420 4.43e-08 ***
#> wt           -5.3798     0.8017  -6.710 2.77e-07 ***
#> am            0.5938     2.1009   0.283    0.780
#> gear         -0.5570     1.2619  -0.441    0.662
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 3.142 on 28 degrees of freedom
#> Multiple R-squared:  0.7545, Adjusted R-squared:  0.7282
#> F-statistic: 28.69 on 3 and 28 DF,  p-value: 1.097e-08
절편(intercept)이 0인 모델을 만들고 싶을 때는 - 1을 추가로 붙여 절편항 자체를 제거합니다.
fit <- lm(mpg ~ wt + cyl - 1, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ wt + cyl - 1, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -13.466  -6.181   1.476  10.597  22.997
#>
#> Coefficients:
#>     Estimate Std. Error t value Pr(>|t|)
#> wt     1.174      3.180   0.369    0.715
#> cyl    2.187      1.660   1.318    0.198
#>
#> Residual standard error: 11.14 on 30 degrees of freedom
#> Multiple R-squared:  0.735,  Adjusted R-squared:  0.7173
#> F-statistic:  41.6 on 2 and 30 DF,  p-value: 2.232e-09
주의: 절편을 제거하면 R²(결정계수)의 정의 자체가 달라져(전체 평균 대신 0을 기준으로 계산) 절편이 있는 모델과 단순 비교할 수 없습니다. 이론적으로 "무게와 실린더 수가 모두 0이면 연비도 0이어야 한다"는 근거가 있을 때만 절편을 제거하는 것이 바람직합니다.
:, * — 상호작용항
:와 *는 상호작용(interaction) 항을 만들 때 사용합니다. :는 두 변수의 상호작용을 직접 지정하는 기호이고, *는 개별항과 그 조합에 해당하는 상호작용항을 자동으로 만들어 주는 축약 기호입니다. 즉 x1 * x2는 x1 + x2 + x1:x2와 동일합니다.
# `:` 로 상호작용항을 직접 지정
fit <- lm(mpg ~ wt + cyl + wt:cyl, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ wt + cyl + wt:cyl, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -4.2288 -1.3495 -0.5042  1.4647  5.2344
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept)  54.3068     6.1275   8.863 1.29e-09 ***
#> wt           -8.6556     2.3201  -3.731 0.000861 ***
#> cyl          -3.8032     1.0050  -3.784 0.000747 ***
#> wt:cyl        0.8084     0.3273   2.470 0.019882 *
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 2.368 on 28 degrees of freedom
#> Multiple R-squared:  0.8606, Adjusted R-squared:  0.8457
#> F-statistic: 57.62 on 3 and 28 DF,  p-value: 4.231e-12
# `*` 로 동일한 모델을 축약해서 표현 -- 결과가 완전히 같은지 확인
fit2 <- lm(mpg ~ wt * cyl, data = mtcars)
attr(terms(fit2), "term.labels")   # 실제로 전개된 항 확인
#> [1] "wt"     "cyl"    "wt:cyl"
wt * cyl이 wt + cyl + wt:cyl로 자동 전개된 것을 terms()로 직접 확인할 수 있습니다. 상호작용항 wt:cyl의 계수가 유의(0.02 미만)하다는 것은, "무게가 연비에 미치는 영향의 크기가 실린더 수에 따라 달라진다"(또는 그 반대)는 뜻으로 해석합니다.
I() — 연산자를 그대로 계산하기
formula 안에서 +, -, *, ^ 같은 연산자는 앞서 본 것처럼 모델 구조를 지정하는 특수한 의미로 해석됩니다. 만약 이 기호들을 원래의 산술 연산(더하기, 곱하기, 거듭제곱)으로 사용하고 싶다면 I() 함수로 감싸주어야 합니다. I()는 "이 안의 내용은 있는 그대로(as-is) 계산하라"는 신호를 줍니다.
# wt의 제곱을 새 설명변수로 사용
fit <- lm(mpg ~ I(wt^2) + cyl, data = mtcars)
summary(fit)
#>
#> Call:
#> lm(formula = mpg ~ I(wt^2) + cyl, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -4.5892 -1.8384 -0.6116  1.6080  6.8836
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept)  35.8818     1.9136  18.751  < 2e-16 ***
#> I(wt^2)      -0.3423     0.1062  -3.223  0.00313 **
#> cyl          -1.9282     0.4070  -4.738 5.25e-05 ***
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 2.798 on 29 degrees of freedom
#> Multiple R-squared:  0.7984, Adjusted R-squared:  0.7845
#> F-statistic: 57.42 on 2 and 29 DF,  p-value: 8.228e-11
I(wt^2)처럼 같은 변수의 거듭제곱 항을 여러 개 넣어 곡선 관계를 표현하는 방법은 뒤에서 다룰 poly()로 더 체계적으로 처리할 수 있습니다.
weights — 가중최소제곱(WLS)
일반 최소제곱법(OLS)은 모든 관측치의 오차 분산이 동일하다고(등분산성) 가정합니다. 그런데 실제 데이터에서는 설명변수 값이 커질수록 반응변수의 흩어짐(분산)도 함께 커지는 이분산(heteroscedasticity) 상황이 흔히 나타납니다. 이런 데이터에 그대로 lm()을 적용하면 계수 자체는 크게 틀리지 않아도 표준오차가 부정확해져 유의성 판단을 그르칠 수 있습니다.
아래처럼 x가 커질수록 오차의 표준편차(sd_true)도 함께 커지도록 인위적으로 만든 데이터를 생각해 봅니다.
set.seed(1)
n <- 50
x <- seq(1, 10, length.out = n)
sd_true <- 0.3 + 0.4 * x            # x가 커질수록 오차의 분산도 커지는 구조
y <- 2 + 1.5 * x + rnorm(n, sd = sd_true)
df_het <- data.frame(x = x, y = y)

fit_ols <- lm(y ~ x, data = df_het)                          # 일반 최소제곱(OLS)
fit_wls <- lm(y ~ x, data = df_het, weights = 1 / sd_true^2) # 가중 최소제곱(WLS)

summary(fit_ols)$coefficients
#>              Estimate Std. Error   t value     Pr(>|t|)
#> (Intercept) 1.965726  0.6667044  2.948422 4.921348e-03
#> x           1.550138  0.1091997 14.195440 8.376537e-19

summary(fit_wls)$coefficients
#>              Estimate Std. Error   t value     Pr(>|t|)
#> (Intercept) 2.026051  0.3446308  5.878902 3.836446e-07
#> x           1.541165  0.0954261 16.150352 4.903940e-21
기울기 추정치(약 1.55, 1.54) 자체는 두 방법이 비슷하지만, 절편의 표준오차가 OLS는 0.667인 반면 WLS는 0.345로 훨씬 작아졌습니다. 분산이 큰 관측치(x가 큰 쪽)의 영향력을 weights = 1/sd_true^2로 낮춰 주었기 때문에, 분산이 작아 신뢰도가 높은 관측치들의 정보가 추정에 더 많이 반영된 결과입니다.
오차의 분산 구조를 알고 있거나 추정할 수 있는 상황이라면, 해당 분산의 역수를 weights 인자에 지정하는 것이 가중최소제곱법의 표준적인 사용법입니다.
na.action — 결측치가 있을 때의 동작 차이
df_na <- data.frame(x = c(1, 2, NA, 4, 5), y = c(2, 4, 5, NA, 10))

fit_omit <- lm(y ~ x, data = df_na, na.action = na.omit)
fit_excl <- lm(y ~ x, data = df_na, na.action = na.exclude)

length(residuals(fit_omit))   # 결측 행이 아예 제거됨
#> [1] 3

length(residuals(fit_excl))   # 결측 행 자리에 NA가 남아 길이가 원본과 같음
#> [1] 5

residuals(fit_excl)
#>  1  2  3  4  5
#>  0  0 NA NA  0
5개 행 중 2개 행(3번째, 4번째)에 결측치가 있는 데이터입니다. na.omit을 쓰면 잔차가 3개만 남아 원본 행 번호와의 대응이 끊어지지만, na.exclude를 쓰면 길이가 5로 유지되어 원본 데이터프레임과 나란히 놓고 비교하기 편리합니다. 계수 추정치 자체는 두 방식이 동일하며, 반환된 값의 형태만 다릅니다.
step()
step(object, scope, scale = 0, direction = c("both", "backward", "forward"), trace = 1, keep = NULL, steps = 1000, k = 2, ...)는 AIC(또는 다른 기준 통계치)를 기준으로 단계적으로 설명변수를 추가·제거하며 모델을 선택하는 함수입니다.
주요 인자
object: 탐색을 시작할 초기 모델(lm()이나glm()의 적합 결과).scope: 단계별 탐색 범위의 하한과 상한을 지정합니다.list(lower = ~1, upper = ~x1+x2+...)형태로 지정하거나, 한쪽만 식으로 넘기면(예제처럼) 그것을 상한으로 간주합니다.scale:AIC대신Cp통계량을 기준으로 삼고 싶을 때 사용하는 오차분산 추정값(0이면AIC/BIC기준 사용). 일반적인 회귀분석에서는 기본값 0을 그대로 둡니다.direction:"both"(기본값, 추가·제거를 모두 시도하는 단계적 선택),"backward"(변수 소거법),"forward"(전진 선택법) 중 선택합니다.trace: 진행 과정을 콘솔에 출력할지 여부. 기본값 1은 매 단계의 AIC 표를 모두 출력하고,0으로 지정하면 중간 과정 없이 최종 결과만 조용히 반환합니다.keep: 각 단계의 중간 결과를 별도로 저장하고 싶을 때 지정하는 함수(잘 쓰이지 않는 고급 옵션).steps: 최대 반복(단계) 횟수. 매우 큰 모델에서 탐색이 끝나지 않는 것을 방지하는 안전장치입니다.k: 각 항에 부여하는 페널티 크기. 기본값 2는 AIC 기준(2 × 파라미터 개수)이며,k = log(n)으로 지정하면 BIC 기준이 됩니다. 표본 수가 큰 경우 AIC는 상대적으로 변수를 많이 남기는 경향이 있어, 더 단순한 모델을 원할 때는k = log(nrow(data))로 BIC 기준을 쓰는 경우도 늘고 있습니다.
개념 정리: 다중회귀분석에서 설명변수를 고르는 방법으로 흔히 다음 세 가지가 언급됩니다.
- 전진선택법(forward selection) : 절편만 있는 모델에서 출발해, 기준 통계치(AIC)를 가장 많이 개선시키는 변수를 한 번에 하나씩 추가합니다.
- 변수소거법(backward elimination) : 모든 후보 변수가 포함된 모델에서 출발해, 기준 통계치에 가장 도움이 안 되는 변수를 하나씩 제거합니다.
- 단계적방법(stepwise selection) : 매 단계마다 변수의 추가와 제거를 모두 시도해 보고 AIC가 가장 좋아지는 쪽을 택합니다. 어느 방향에서 출발하든(절편만 있는 모델이든, 모든 변수를 포함한 모델이든) 매 단계에서 추가·제거를 모두 고려한다는 점이 전진/후진 방법과 다릅니다.
주의: 단계적 변수 선택은 어디까지나 참고용 탐색 도구입니다. 회귀분석에서 어떤 설명변수를 쓸지는 우선 이론이나 현장 지식을 바탕으로 정하는 것이 먼저이며, 가능한 모든 변수를 기계적으로 넣고
step()만으로 "최적 모델"을 찾으려 하면 통계적으로는 그럴듯해 보이지만 실질적인 의미가 없는 모델이 나오기 쉽습니다. 또한 최근에는 이런 단계적 선택법 대신 LASSO 같은 정규화(regularization) 기법을 함께 검토하는 경우도 많아졌지만, 이는 별도 패키지가 필요한 Base R 범위 밖의 주제이므로 이 매뉴얼에서는 다루지 않습니다.
변수소거법(backward)을 예로 전체 과정을 살펴보겠습니다. 절편을 포함한 모든 후보 변수로 시작해서, 매 단계마다 "이 변수를 빼면 AIC가 어떻게 바뀌는가"를 표로 보여주며 가장 AIC가 낮아지는 방향으로 변수를 하나씩 제거해 나갑니다.
fit_full <- lm(mpg ~ cyl + disp + hp + drat + wt + vs + am, data = mtcars)
fit_bwd <- step(fit_full, direction = "backward")
#> Start:  AIC=67.23
#> mpg ~ cyl + disp + hp + drat + wt + vs + am
#>
#>        Df Sum of Sq    RSS    AIC
#> - drat  1     0.867 159.52 65.406
#> - cyl   1     3.366 162.02 65.904
#> - vs    1     3.779 162.43 65.985
#> - am    1     8.163 166.82 66.837
#> - disp  1     8.182 166.84 66.841
#> <none>              158.65 67.232
#> - hp    1    28.146 186.80 70.458
#> - wt    1    51.076 209.73 74.163
#>
#> Step:  AIC=65.41
#> mpg ~ cyl + disp + hp + wt + vs + am
#>
#>        Df Sum of Sq    RSS    AIC
#> - vs    1     3.598 163.12 64.120
#> - cyl   1     4.789 164.31 64.353
#> - disp  1     7.793 167.31 64.932
#> <none>              159.52 65.406
#> - am    1    10.767 170.29 65.496
#> - hp    1    27.295 186.82 68.461
#> - wt    1    52.392 211.91 72.494
#>
#> Step:  AIC=64.12
#> mpg ~ cyl + disp + hp + wt + am
#>
#>        Df Sum of Sq    RSS    AIC
#> - disp  1     6.878 170.00 63.442
#> - am    1     7.325 170.44 63.526
#> <none>              163.12 64.120
#> - cyl   1    16.788 179.91 65.255
#> - hp    1    25.306 188.43 66.735
#> - wt    1    53.247 216.37 71.160
#>
#> Step:  AIC=63.44
#> mpg ~ cyl + hp + wt + am
#>
#>        Df Sum of Sq    RSS    AIC
#> - am    1     6.623 176.62 62.665
#> - cyl   1    10.293 180.29 63.323
#> <none>              170.00 63.442
#> - hp    1    21.049 191.05 65.177
#> - wt    1    50.555 220.55 69.773
#>
#> Step:  AIC=62.66
#> mpg ~ cyl + hp + wt
#>
#>        Df Sum of Sq    RSS    AIC
#> <none>              176.62 62.665
#> - hp    1    14.551 191.17 63.198
#> - cyl   1    18.427 195.05 63.840
#> - wt    1   115.354 291.98 76.750

summary(fit_bwd)
#>
#> Call:
#> lm(formula = mpg ~ cyl + hp + wt, data = mtcars)
#>
#> Residuals:
#>     Min      1Q  Median      3Q     Max
#> -3.9290 -1.5598 -0.5311  1.1850  5.8986
#>
#> Coefficients:
#>             Estimate Std. Error t value Pr(>|t|)
#> (Intercept) 38.75179    1.78686  21.687  < 2e-16 ***
#> cyl         -0.94162    0.55092  -1.709 0.098480 .
#> hp          -0.01804    0.01188  -1.519 0.140015
#> wt          -3.16697    0.74058  -4.276 0.000199 ***
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 2.512 on 28 degrees of freedom
#> Multiple R-squared:  0.8431, Adjusted R-squared:  0.8263
#> F-statistic: 50.17 on 3 and 28 DF,  p-value: 2.184e-11
각 단계의 표에서 <none>(아무것도 빼지 않음)보다 AIC가 낮은 항목이 있으면 그 변수를 제거하고, 더 이상 개선되지 않으면(즉 <none>의 AIC가 가장 낮으면) 탐색을 멈춥니다. 최종적으로 cyl, hp, wt 세 변수만 남았습니다.
trace = 0으로 지정하면 중간 표 없이 최종 모델만 조용히 얻을 수 있습니다. 절편만 있는 모델에서 출발한 전진선택법과 단계적방법도 함께 확인해 보면, 이 데이터에서는 세 방법 모두 결국 같은 모델로 수렴하는 것을 볼 수 있습니다.
fit_null <- lm(mpg ~ 1, data = mtcars)

fit_fwd <- step(fit_null, direction = "forward",
                 scope = (mpg ~ cyl + disp + hp + drat + wt + vs + am),
                 trace = 0)
formula(fit_fwd); AIC(fit_fwd)
#> mpg ~ wt + cyl + hp
#> [1] 155.4766

fit_both <- step(fit_null, direction = "both",
                  scope = (mpg ~ cyl + disp + hp + drat + wt + vs + am),
                  trace = 0)
formula(fit_both); AIC(fit_both)
#> mpg ~ wt + cyl + hp
#> [1] 155.4766
세 방법 모두 wt, cyl, hp로 이루어진 동일한 모델(AIC = 155.48)에 도달했습니다. 다만 이는 이 데이터에서 우연히 세 방법이 일치한 것일 뿐, 일반적으로는 출발점과 방향에 따라 서로 다른 모델이 선택될 수 있다는 점을 기억해야 합니다.
predict()
predict(object, ...)는 적합된 모형에 새로운 데이터를 적용해 예측값을 구하는 제네릭(generic) 함수입니다. lm(), glm()처럼 모형을 적합하는 함수는 각각 클래스가 다른 객체를 반환하는데, predict()는 object의 클래스를 보고 그에 맞는 실제 계산 함수(메서드)를 자동으로 골라 호출합니다. 이런 제네릭 함수와 메서드 디스패치(dispatch)의 원리는 19장(R 객체와 클래스)에서 더 자세히 다룹니다.
predict()가 내부적으로 호출하는 대표적인 메서드는 다음과 같습니다.
predict.lm— 선형회귀 (lm())predict.glm— 일반화선형모형 (glm())predict.nls— 비선형회귀 (nls())predict.poly— 직교다항식 변환 (poly())predict.princomp/predict.prcomp— 주성분분석predict.loess— 국소가중회귀 평활 (9.4절)predict.smooth.spline— 평활 스플라인 (9.4절)predict.ar/predict.Arima/predict.HoltWinters/predict.StructTS— 시계열 모형 (9.5절)
이 중 가장 널리 쓰이는 predict.lm() 기준으로 predict(object, newdata, se.fit = FALSE, scale = NULL, df = Inf, interval = c("none", "confidence", "prediction"), level = 0.95, type = c("response", "terms"), terms = NULL, na.action = na.pass, ...)의 주요 인자는 다음과 같습니다.
object: 예측에 사용할 적합된 모형 객체.newdata: 예측하고 싶은 새로운 설명변수 값들을 담은 데이터프레임. 열 이름이 적합에 사용된 변수명과 정확히 일치해야 합니다. 생략하면 적합에 사용된 원래 데이터에 대한 예측값(=적합값,fitted()와 동일)을 반환합니다.se.fit:TRUE로 지정하면 예측값과 함께 표준오차(standard error)도 함께 반환합니다.interval:"none"(기본값, 구간 없이 예측값만),"confidence"(평균 반응에 대한 신뢰구간),"prediction"(개별 관측값에 대한 예측구간) 중 선택합니다. 예측구간은 신뢰구간보다 항상 더 넓은데, 평균의 불확실성뿐 아니라 개별 관측치가 갖는 오차의 흩어짐까지 함께 고려하기 때문입니다.level: 신뢰수준·예측수준. 기본값 0.95(95%).type:"response"(반응변수 척도의 예측값, 기본값)와"terms"(각 항이 예측값에 기여하는 정도를 항별로 분리해서 반환) 중 선택.na.action:newdata에 결측치가 있을 때의 처리 방법.
fit <- lm(mpg ~ wt + cyl, data = mtcars)

# 예측값만
predict(fit, newdata = data.frame(wt = 2.595, cyl = 6))
#>        1
#> 22.35892

# 예측의 신뢰구간(평균 반응에 대한 구간) 추가
predict(fit, newdata = data.frame(wt = 2.595, cyl = 6), interval = "confidence")
#>        fit      lwr      upr
#> 1 22.35892 21.10387 23.61397

# 예측구간(개별 관측값에 대한 구간, 신뢰구간보다 폭이 넓음) 추가
predict(fit, newdata = data.frame(wt = 2.595, cyl = 6), interval = "prediction")
#>        fit      lwr      upr
#> 1 22.35892 16.95986 27.75798
새로운 관측치 여러 개를 한 번에 예측하면서 표준오차도 함께 받고 싶다면 se.fit = TRUE를 지정합니다.
newcars <- data.frame(wt = c(2.0, 3.0, 4.0), cyl = c(4, 6, 8))
predict(fit, newdata = newcars, se.fit = TRUE)
#> $fit
#>        1        2        3
#> 27.27314 21.06658 14.86001
#>
#> $se.fit
#>         1         2         3
#> 0.7548361 0.4680601 0.6519578
#>
#> $df
#> [1] 29
#>
#> $residual.scale
#> [1] 2.567516
무게가 무거운 자동차(wt = 4.0)에 대한 예측의 표준오차(0.652)가 중간 무게(wt = 3.0)의 표준오차(0.468)보다 큰 것을 볼 수 있는데, 이는 데이터의 무게 분포 중심(평균)에서 멀어질수록 예측의 불확실성이 커지는 회귀분석의 일반적인 특징입니다.
glm()
glm(formula, family = gaussian, data, weights, subset, na.action, start = NULL, etastart, mustart, offset, control = list(...), model = TRUE, method = "glm.fit", x = FALSE, y = TRUE, singular.ok = TRUE, contrasts = NULL, ...)는 일반화선형모형(GLM, Generalized Linear Model)을 적합시키는 함수입니다.
lm()은 반응변수가 (근사적으로) 정규분포를 따르는 연속형 변수라고 가정합니다. 그런데 반응변수가 "합격/불합격"처럼 두 값 중 하나인 이항형이거나, "하루 방문자 수"처럼 0 이상의 정수인 개수형이라면 이 가정이 성립하지 않아 lm()을 그대로 쓰기 어렵습니다. 예를 들어 이항형 반응변수에 lm()을 적용하면 예측값이 0보다 작거나 1보다 큰, 확률로 말이 안 되는 값이 나올 수 있습니다.
일반화선형모형은 반응변수의 분포(family)와, 설명변수들의 선형결합을 반응변수의 척도로 연결해 주는 연결함수(link function)를 지정함으로써 이 문제를 해결합니다. glm()의 인자는 대부분 lm()과 같으며, family 인자만 추가로 지정합니다.
family: 반응변수의 확률분포와 연결함수를 함께 지정합니다.
| family | 기본 연결함수 | 반응변수 예시 |
|---|---|---|
gaussian |
identity(항등) | 연속형 (기본값, lm()과 동등) |
binomial |
logit | 이항형(0/1, 성공/실패) — 로지스틱 회귀 |
poisson |
log | 개수형(사건 발생 횟수) |
Gamma |
inverse | 양의 연속형(대기시간 등, 오른쪽으로 긴 꼬리) |
inverse.gaussian |
1/mu^2 | 양의 연속형 |
quasibinomial |
logit | 이항형이지만 분산이 이론값보다 크게 퍼진(과대산포) 경우 |
quasipoisson |
log | 개수형이지만 과대산포가 있는 경우 |
가장 흔히 쓰이는 것은 이항형 반응변수를 다루는 로지스틱 회귀(family = binomial)입니다. 다음 예제는 마력(hp)과 무게(wt)로 변속기 종류(am: 0=오토, 1=수동)를 예측하는 로지스틱 회귀입니다.
fit <- glm(am ~ hp + wt, data = mtcars, family = binomial)
summary(fit)
#>
#> Call:
#> glm(formula = am ~ hp + wt, family = binomial, data = mtcars)
#>
#> Coefficients:
#>             Estimate Std. Error z value Pr(>|z|)
#> (Intercept) 18.86630    7.44356   2.535  0.01126 *
#> hp           0.03626    0.01773   2.044  0.04091 *
#> wt          -8.08348    3.06868  -2.634  0.00843 **
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> (Dispersion parameter for binomial family taken to be 1)
#>
#>     Null deviance: 43.230  on 31  degrees of freedom
#> Residual deviance: 10.059  on 29  degrees of freedom
#> AIC: 16.059
#>
#> Number of Fisher Scoring iterations: 8
predict()의 type 인자에 따라 결과의 척도가 달라집니다. type = "link"는 연결함수 척도(로지스틱 회귀에서는 로그오즈, log-odds)의 값을, type = "response"는 다시 원래 척도(확률)로 변환한 값을 돌려줍니다.
newdata <- data.frame(hp = c(120, 150), wt = c(2.8, 3.8))

predict(fit, newdata = newdata, type = "link")       # 로그오즈(log-odds)
#>          1          2
#>  0.5832397 -6.4125676

predict(fit, newdata = newdata, type = "response")   # 확률
#>           1           2
#> 0.641812528 0.001638118
마력 120·무게 2.8인 차는 수동변속기일 확률이 약 64%, 마력 150·무게 3.8인(더 무거운) 차는 약 0.16%로 예측되어, "무거운 차일수록 수동변속기일 가능성이 낮다"는 앞선 회귀계수(wt의 음수 부호)의 해석과 일치합니다.
family = poisson을 지정하면 개수형 반응변수에도 같은 방식으로 접근할 수 있습니다. 예를 들어 자동차의 기화기(carb) 개수처럼 음이 아닌 정수를 반응변수로 삼는 경우입니다.
fit_pois <- glm(carb ~ hp + wt, data = mtcars, family = poisson)
summary(fit_pois)
#>
#> Call:
#> glm(formula = carb ~ hp + wt, family = poisson, data = mtcars)
#>
#> Coefficients:
#>             Estimate Std. Error z value Pr(>|z|)
#> (Intercept) 0.138788   0.398666   0.348 0.727741
#> hp          0.005487   0.001644   3.337 0.000846 ***
#> wt          0.004482   0.130972   0.034 0.972701
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> (Dispersion parameter for poisson family taken to be 1)
#>
#>     Null deviance: 27.043  on 31  degrees of freedom
#> Residual deviance: 12.278  on 29  degrees of freedom
#> AIC: 107.64
#>
#> Number of Fisher Scoring iterations: 4
hp의 계수만 유의하게 나타나, 마력이 높은 차일수록 기화기 개수가 많은 경향이 있다는 것을 확인할 수 있습니다.
nls()
nls(formula, data = parent.frame(), start, control = nls.control(), algorithm = c("default", "plinear", "port"), trace = FALSE, subset, weights, na.action, model = FALSE, lower = -Inf, upper = Inf, ...)는 비선형최소제곱법(Nonlinear Least Squares)으로 모형을 적합시키는 함수입니다.
lm()과 poly()(바로 다음 절)는 계수에 대해서는 선형인 모델(계수를 곱하고 더하는 형태)만 다룰 수 있습니다. 그런데 효소 반응 속도, 인구 성장, 방사성 붕괴처럼 이론적으로 이미 함수식이 정해져 있고 그 식 자체가 계수에 대해 비선형인 경우(예: 계수가 지수나 분모에 들어가는 경우)가 많습니다. 이런 관계는 lm()으로 억지로 흉내 낼 수 없고, 주어진 비선형 함수식 그대로 최소제곱 적합을 해야 합니다.
R에 내장된 Puromycin 데이터셋은 효소 반응에서 기질 농도(conc)에 따른 반응 속도(rate)를 담고 있습니다.
data(Puromycin)
head(Puromycin, 4)
#>   conc rate   state
#> 1 0.02   76 treated
#> 2 0.02   47 treated
#> 3 0.06   97 treated
#> 4 0.06  107 treated
효소반응속도론에서는 이 관계가 미카엘리스-멘텐(Michaelis-Menten) 방정식 rate = Vm × conc / (K + conc)을 따른다고 알려져 있습니다. 이 식은 모수 Vm, K에 대해 비선형이므로 nls()로 적합합니다.
주요 인자
formula:반응변수 ~ 비선형식형태로, 식 안에 추정하고자 하는 모수의 이름을 그대로 씁니다.data: 변수들이 들어있는 데이터프레임.start: 각 모수의 초기값을 담은 리스트.lm()과 달리nls()는 반복적인 수치 최적화로 해를 찾기 때문에 시작점이 필요하며, 이 값이 실제 값과 너무 동떨어져 있으면 수렴에 실패하거나 엉뚱한 국소해로 수렴할 수 있습니다.nls()에서 가장 중요한 인자라고 할 수 있습니다.algorithm: 최적화 알고리즘. 기본값"default"(Gauss-Newton 방법) 외에"plinear"(선형 모수와 비선형 모수를 분리해 계산),"port"(모수에 상한·하한 제약을 걸 수 있는 PORT 라이브러리 알고리즘)를 선택할 수 있습니다.control: 최대 반복 횟수, 수렴 판정 기준 등을 세부 조정하는nls.control()객체.trace:TRUE로 지정하면 매 반복 단계마다 잔차제곱합이 줄어드는 과정을 출력합니다.lower,upper:algorithm = "port"일 때 각 모수의 하한·상한을 지정합니다(예: 물리적으로 음수가 될 수 없는 모수를 0 이상으로 제한).
fit_nls <- nls(rate ~ Vm * conc / (K + conc),
               data = Puromycin,
               start = list(Vm = 200, K = 0.1))
summary(fit_nls)
#>
#> Formula: rate ~ Vm * conc/(K + conc)
#>
#> Parameters:
#>     Estimate Std. Error t value Pr(>|t|)
#> Vm 190.80620    8.76458  21.770 6.84e-16 ***
#> K    0.06039    0.01077   5.608 1.45e-05 ***
#> ---
#> Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> Residual standard error: 18.61 on 21 degrees of freedom
#>
#> Number of iterations to convergence: 6
#> Achieved convergence tolerance: 6.272e-06

predict(fit_nls, newdata = data.frame(conc = c(0.3, 0.6, 1.0)))
#> [1] 158.8337 173.3581 179.9399
Vm(최대반응속도)은 약 190.8, K(반포화상수)는 약 0.060으로 추정되었습니다. predict()가 여기서도 그대로 쓰이는 것을 볼 수 있습니다(predict.nls가 내부적으로 호출됨).
주의:
start를 생략하거나 잘못 지정하면?
start를 아예 생략하면 R은 모든 모수를 1로 두고 시도해 보라는 경고와 함께 계산을 진행합니다. 이 데이터에서는 그래도 수렴은 하지만, 물리적으로 말이 안 되는 값(K가 음수)으로 수렴해 버립니다. "에러 없이 수렴했다"는 것이 "의미 있는 해를 찾았다"는 뜻은 아님을 보여주는 사례입니다.fit_default <- nls(rate ~ Vm * conc / (K + conc), data = Puromycin) #> Warning message: #> In nls(rate ~ Vm * conc/(K + conc), data = Puromycin) : #> No starting values specified for some parameters. #> Initializing 'Vm', 'K' to '1.'. #> Consider specifying 'start' or using a selfStart model summary(fit_default) #> Parameters: #> Estimate Std. Error t value Pr(>|t|) #> Vm 17.2687 33.3683 0.518 0.610204 #> K -0.5057 0.1064 -4.753 0.000108 ***초기값이 실제 값에서 너무 멀리 떨어져 있으면(예: 아래처럼 둘 다 크게 음수) 아예 계산이 실패하며 에러가 발생합니다.
이런 번거로움을 줄이기 위해 R은 대표적인 비선형 모델에 대해 초기값을 자동으로 계산해 주는 selfStart 모델을 제공합니다. 미카엘리스-멘텐 모델의 경우 SSmicmen()을 쓰면 start를 지정하지 않아도 됩니다.
fit_ss <- nls(rate ~ SSmicmen(conc, Vm, K), data = Puromycin)
summary(fit_ss)
#> Formula: rate ~ SSmicmen(conc, Vm, K)
#>
#> Parameters:
#>     Estimate Std. Error t value Pr(>|t|)
#> Vm 190.80667    8.76462  21.770 6.84e-16 ***
#> K    0.06039    0.01077   5.608 1.45e-05 ***
#> ---
#> Residual standard error: 18.61 on 21 degrees of freedom
앞서 start를 직접 지정했을 때와 거의 동일한 결과(Vm ≈ 190.8, K ≈ 0.060)를 start 없이 얻었습니다. ?selfStart를 참고하면 SSlogis(로지스틱 성장곡선), SSasymp(지수적 점근곡선) 등 다른 selfStart 모델도 확인할 수 있습니다.
poly()
poly(x, ..., degree = 1, coefs = NULL, raw = FALSE, simple = FALSE)는 벡터로부터 직교다항식(orthogonal polynomial) 기저를 만드는 함수로, lm()의 formula 안에서 다항회귀를 표현할 때 주로 사용합니다.
관계가 직선이 아니라 곡선(2차·3차 곡선 등)으로 보일 때, I(x^2), I(x^3)처럼 거듭제곱 항을 formula에 직접 나열할 수도 있습니다. 그러나 이렇게 만든 x, x^2, x^3 항들은 서로 강한 상관관계를 가져(다중공선성) 계수의 표준오차가 불안정해지기 쉽습니다.
wt의 원래 값과 그 제곱값의 상관관계를 직접 확인해 보면 매우 높습니다.
poly(x, degree, raw = FALSE)(기본값)는 원래 값의 거듭제곱을 그대로 쓰는 대신, 서로 상관관계가 0이 되도록 수학적으로 직교화한 다항식 기저를 만들어 줍니다.
X_orth <- poly(mtcars$wt, 2)   # raw = FALSE(기본값)
cor(X_orth[, 1], X_orth[, 2])
#> [1] -1.048203e-18   (사실상 0)
raw = FALSE(직교, 기본값)로 적합한 모델과 raw = TRUE(원래 거듭제곱 그대로)로 적합한 모델은 예측값과 F-검정 결과는 완전히 동일하지만, 계수의 해석과 안정성이 다릅니다.
fit_orth <- lm(mpg ~ poly(wt, 2), data = mtcars)               # 직교다항식(기본값)
summary(fit_orth)
#>
#> Call:
#> lm(formula = mpg ~ poly(wt, 2), data = mtcars)
#>
#> Coefficients:
#>              Estimate Std. Error t value Pr(>|t|)
#> (Intercept)   20.0906     0.4686  42.877  < 2e-16 ***
#> poly(wt, 2)1 -29.1157     2.6506 -10.985 7.52e-12 ***
#> poly(wt, 2)2   8.6358     2.6506   3.258  0.00286 **
#> ---
#> Residual standard error: 2.651 on 29 degrees of freedom
#> Multiple R-squared:  0.8191, Adjusted R-squared:  0.8066
#> F-statistic: 65.64 on 2 and 29 DF,  p-value: 1.715e-11

fit_raw <- lm(mpg ~ poly(wt, 2, raw = TRUE), data = mtcars)    # 원래 거듭제곱 그대로
summary(fit_raw)
#>
#> Call:
#> lm(formula = mpg ~ poly(wt, 2, raw = TRUE), data = mtcars)
#>
#> Coefficients:
#>                          Estimate Std. Error t value Pr(>|t|)
#> (Intercept)               49.9308     4.2113  11.856 1.21e-12 ***
#> poly(wt, 2, raw = TRUE)1 -13.3803     2.5140  -5.322 1.04e-05 ***
#> poly(wt, 2, raw = TRUE)2   1.1711     0.3594   3.258  0.00286 **
#> ---
#> Residual standard error: 2.651 on 29 degrees of freedom
#> Multiple R-squared:  0.8191, Adjusted R-squared:  0.8066
#> F-statistic: 65.64 on 2 and 29 DF,  p-value: 1.715e-11
두 모델의 R²(0.8191)와 F-통계량(65.64)은 완전히 같습니다. raw = TRUE로 얻은 계수(-13.38, 1.17)는 lm(mpg ~ wt + I(wt^2))로 직접 적합했을 때의 계수와 정확히 일치해, "원래 척도(무게, 무게제곱)로 해석하고 싶다면 raw = TRUE를 쓰면 된다"는 것을 확인할 수 있습니다.
coef(lm(mpg ~ wt + I(wt^2), data = mtcars))
#> (Intercept)          wt     I(wt^2)
#>   49.930811  -13.380337    1.171087
주요 인자
x: 다항식을 만들 대상 벡터.degree: 다항식의 최고차수(2차, 3차 등).coefs: 이미 계산된 직교다항식의 계수를 재사용할 때 지정(아래predict()와의 관계에서 자동으로 활용됨).raw:FALSE(기본값, 직교다항식 — 수치적으로 안정적이고 각 항의 유의성 검정에 적합),TRUE(원래 거듭제곱 — 계수의 해석이 직관적).simple:TRUE로 지정하면 속성(attributes) 없이 행렬만 간단히 반환(내부용, 일반적으로는 잘 쓰지 않음).
주의: 새 데이터를 예측할 때는 반드시
predict()를 통해야 합니다직교다항식은 "그 데이터 안에서" 상관관계가 0이 되도록 계산되므로, 훈련에 사용한 데이터와 새 데이터를 각각 따로
poly()에 넣으면 서로 다른 변환이 만들어집니다. 반드시 적합된 모델 객체를 통해predict()로 예측해야 훈련 시점의 변환이 그대로 재사용됩니다.fit_orth <- lm(mpg ~ poly(wt, 2), data = mtcars) # (올바른 방법) predict()는 학습 시 사용한 직교변환(coefs)을 자동으로 재사용 predict(fit_orth, newdata = data.frame(wt = c(2, 3, 4))) #> 1 2 3 #> 27.85448 20.32958 15.14685 # (틀리기 쉬운 방법) 새 데이터 3개만으로 poly()를 다시 계산해 대입하면 완전히 다른 값이 나옴 new_poly <- poly(c(2, 3, 4), 2) cf <- coef(fit_orth) as.numeric(cf[1] + cf[2]*new_poly[,1] + cf[3]*new_poly[,2]) #> [1] 44.204087 13.039550 3.028238두 결과가 크게 다른 것을 볼 수 있습니다.
predict.poly()가 내부적으로 원래 데이터의coefs속성을 그대로 물려받아 사용하기 때문에, 항상 모델 객체를 통해 예측해야 합니다.
princomp()
princomp(x, cor = FALSE, scores = TRUE, covmat = NULL, subset, ...)는 주성분분석(PCA, Principal Component Analysis)을 수행하는 함수입니다.
변수(차원)가 여러 개일 때, 변수들끼리 서로 겹치는 정보를 담고 있어 실제로 데이터가 담고 있는 "독립적인 정보의 축"은 원래 변수 개수보다 적은 경우가 많습니다. 예를 들어 자동차의 배기량·마력·무게는 서로 강한 상관관계를 가지므로, 이 세 변수를 각각 따로 보는 대신 "차체의 크기"라는 하나의 축으로 요약할 수 있다면 데이터를 더 간결하게 이해할 수 있습니다.
주성분분석은 원래 변수들의 선형결합으로 새로운 축(주성분)을 만들되, 첫 번째 축이 데이터의 분산(정보량)을 가장 많이 설명하고, 그다음 축들이 서로 상관관계 없이(직교) 나머지 분산을 순서대로 많이 설명하도록 구성합니다.
주요 인자
x: 수치형 변수들로 이루어진 데이터프레임 또는 행렬. 결측치가 없어야 합니다.cor:TRUE이면 각 변수를 표준화(평균 0, 분산 1)한 상관행렬 기준으로,FALSE(기본값)이면 원래 척도의 공분산행렬 기준으로 분석합니다. 변수들의 측정 단위나 분산 크기가 서로 많이 다르면(예: 배기량은 수백 단위, 승수비는 소수점 단위) 반드시cor = TRUE를 지정해야 특정 변수가 단지 숫자가 크다는 이유만으로 결과를 지배하는 것을 막을 수 있습니다.scores:TRUE(기본값)이면 각 관측치를 새 주성분 축에 투영한 점수(scores)를 함께 반환합니다.covmat: 원자료 대신 이미 계산된 공분산(또는 상관)행렬을 직접 넘길 때 사용합니다.subset: 일부 행만 분석에 사용하고 싶을 때 지정.
측정 단위가 서로 다른 변수들이 섞여 있으므로 cor = TRUE로 분석합니다.
vars <- c("mpg", "disp", "hp", "drat", "wt", "qsec")
pca_fit <- princomp(mtcars[, vars], cor = TRUE)
summary(pca_fit)
#> Importance of components:
#>                           Comp.1    Comp.2     Comp.3     Comp.4     Comp.5
#> Standard deviation     2.0463129 1.0714999 0.57737047 0.39288744 0.35326479
#> Proportion of Variance 0.6978994 0.1913520 0.05555944 0.02572676 0.02079933
#> Cumulative Proportion  0.6978994 0.8892514 0.94481088 0.97053763 0.99133697
#>                             Comp.6
#> Standard deviation     0.227987246
#> Proportion of Variance 0.008663031
#> Cumulative Proportion  1.000000000
첫 번째 주성분(Comp.1) 하나만으로 전체 분산의 약 70%를, 두 번째까지 합치면 약 89%를 설명합니다. 즉 원래 6개였던 변수를 주성분 2개 정도로 요약해도 정보 손실이 크지 않다는 뜻입니다. 각 주성분이 원래 변수들을 어떤 비중으로 조합한 것인지는 loadings()로 확인합니다.
loadings(pca_fit)
#> Loadings:
#>      Comp.1 Comp.2 Comp.3 Comp.4 Comp.5 Comp.6
#> mpg   0.459         0.195  0.782  0.111  0.352
#> disp -0.466                0.600 -0.295 -0.568
#> hp   -0.426  0.361 -0.146  0.123  0.806
#> drat  0.367  0.437 -0.800        -0.144 -0.113
#> wt   -0.439 -0.300 -0.418  0.104 -0.230  0.692
#> qsec  0.253 -0.763 -0.341         0.422 -0.242
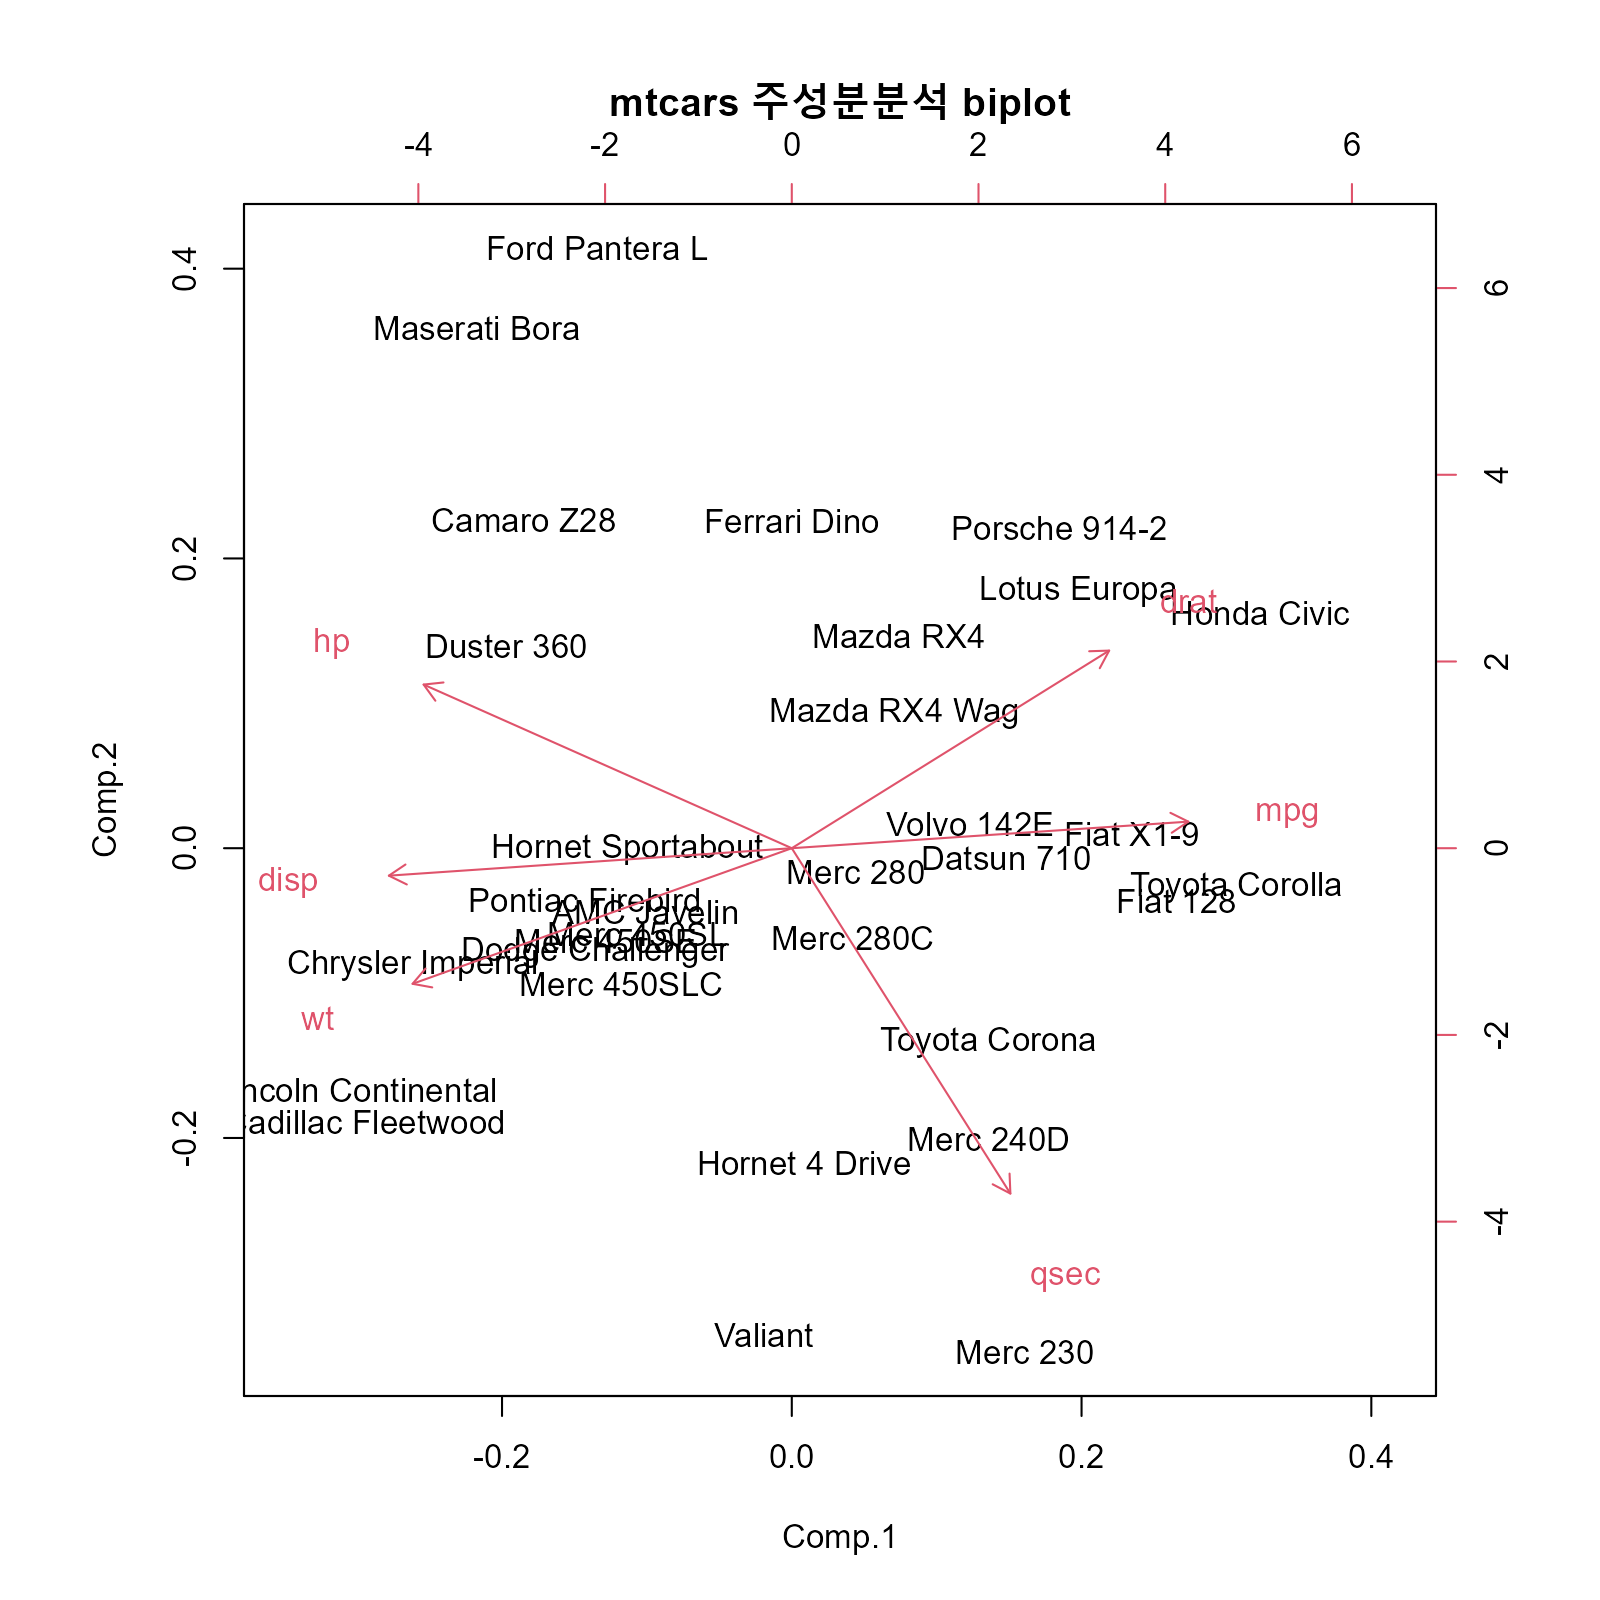
첫 번째 주성분(Comp.1)은 mpg가 양(+)의 부호, disp·hp·wt가 음(-)의 부호로 실려 있습니다. 즉 "배기량·마력·무게가 크면서 연비가 낮은 차"일수록 Comp.1 값이 작아지는(또는 부호를 뒤집어 해석하면 커지는) 축으로, "차체가 크고 무거운 정도"를 나타내는 축으로 해석할 수 있습니다. 각 자동차가 이 새 축 위에서 어떤 값을 갖는지는 scores(또는 predict())로 얻습니다.
head(pca_fit$scores, 4)
#>                    Comp.1      Comp.2    Comp.3     Comp.4      Comp.5
#> Mazda RX4      0.85606279  0.88744579 0.2319310 -0.3802613 -0.52347056
#> Mazda RX4 Wag  0.82042501  0.56524358 0.0128705 -0.3390325 -0.45008713
#> Datsun 710     1.71200719 -0.04064671 0.1589977 -0.4122076  0.03393884
#> Hornet 4 Drive 0.09798751 -1.31508927 0.5793540  0.2561123  0.04395244
주성분 2개(Comp.1, Comp.2)만으로 관측치들을 2차원 평면에 그려 살펴보고 싶다면 biplot()을 사용합니다.
참고:
princomp()와prcomp(), 어느 쪽을 쓸까?R은 주성분분석을 위한 함수를 두 개 제공합니다.
princomp()는 고전적인 다변량통계 교과서의 정의(공분산행렬의 고유값분해, eigen decomposition)를 그대로 따르는 함수이고,prcomp()는 특이값분해(SVD, Singular Value Decomposition)를 이용하는 함수로 수치적으로 더 안정적입니다. 최근에는 데이터 분석 실무에서prcomp()를 더 널리 권장하는 추세이며, 결과를 확인하면 두 함수의 값이 사실상 같다는 것을 알 수 있습니다.pca_fit2 <- prcomp(mtcars[, vars], scale. = TRUE) # cor=TRUE에 대응하는 옵션은 scale.=TRUE summary(pca_fit2) #> Importance of components: #> PC1 PC2 PC3 PC4 PC5 PC6 #> Standard deviation 2.0463 1.0715 0.57737 0.39289 0.3533 0.22799 #> Proportion of Variance 0.6979 0.1913 0.05556 0.02573 0.0208 0.00866 #> Cumulative Proportion 0.6979 0.8892 0.94481 0.97054 0.9913 1.00000표준화된(상관행렬 기준) 분석에서는 두 함수의 표준편차(sdev)가 완전히 같습니다. 다만 표준화하지 않은 원자료(공분산행렬) 기준으로 비교하면 미묘한 차이가 드러납니다.
princomp()는 분산을 관측치 수n으로 나누고,prcomp()는 표본분산과 마찬가지로n-1로 나누기 때문입니다.p1 <- princomp(mtcars[, vars]) # cor = FALSE(기본값) p2 <- prcomp(mtcars[, vars]) # scale. = FALSE(기본값) p2$sdev / p1$sdev #> Comp.1 Comp.2 Comp.3 Comp.4 Comp.5 Comp.6 #> 1.016001 1.016001 1.016001 1.016001 1.016001 1.016001 sqrt(nrow(mtcars) / (nrow(mtcars) - 1)) #> [1] 1.016001정확히 sqrt(n/(n-1))배만큼 차이가 나며, 표준화(상관행렬) 기준에서는 이 비율 차이가 서로 상쇄되어 사라집니다. 즉
cor = TRUE(prcomp에서는scale. = TRUE)로 분석한다면 어느 함수를 쓰든 결과는 사실상 같으므로, 새로 작성하는 코드라면 수치적으로 더 안정적인prcomp()를 우선 고려하는 것을 권장합니다.princomp()는 관측치 수가 변수 수보다 반드시 많아야 한다는 제약도 있지만prcomp()에는 이 제약이 없습니다.